Я долго относился к промптам как к умению подобрать правильные слова. Добавить роль, попросить «думать пошагово», расписать десять требований и надеяться, что нейросеть послушается. Чем сильнее становятся модели, тем меньше этот подход похож на инженерную работу и тем больше напоминает перебор заклинаний.
Сейчас рабочая единица уже шире одного сообщения. В неё входят исходные данные, примеры, инструменты, история диалога, формат результата и проверка. Anthropic называет этот сдвиг переходом от prompt engineering к context engineering, то есть от редактирования одной инструкции к управлению всем контекстом, который получает модель.
Ниже я собрал техники, которые пережили смену нескольких поколений моделей, и отделил их от советов, которые сегодня дают больше шума, чем контроля.
Почему хороший промпт начинается не с роли
Фраза «ты лучший маркетолог мира» почти ничего не сообщает модели о задаче. Она может немного изменить тон ответа, но не объясняет, какой результат считать хорошим, для кого он написан и на каких данных основан.
Намного полезнее начать с проверяемого результата. Например, не «ты опытный редактор, напиши сильную статью», а «собери черновик на 1200–1500 слов для владельцев малого бизнеса, используй только приложенные источники, каждому совету добавь пример, спорные факты пометь». Во второй версии меньше театра и больше информации, которая реально влияет на ответ.
Исследование Anthropic по контексту предлагает начинать с минимальной инструкции на сильной модели, смотреть на реальные сбои и только после этого добавлять правила и примеры. Это хорошая страховка от промптов на три страницы, в которых требования начинают конфликтовать друг с другом.
Из каких шести блоков собрать промпт для текста
Формула ниже подходит для ChatGPT, Claude, Gemini и большинства других языковых моделей. Не обязательно заполнять каждый блок в простом вопросе, но для повторяемой рабочей задачи они дают удобный каркас.
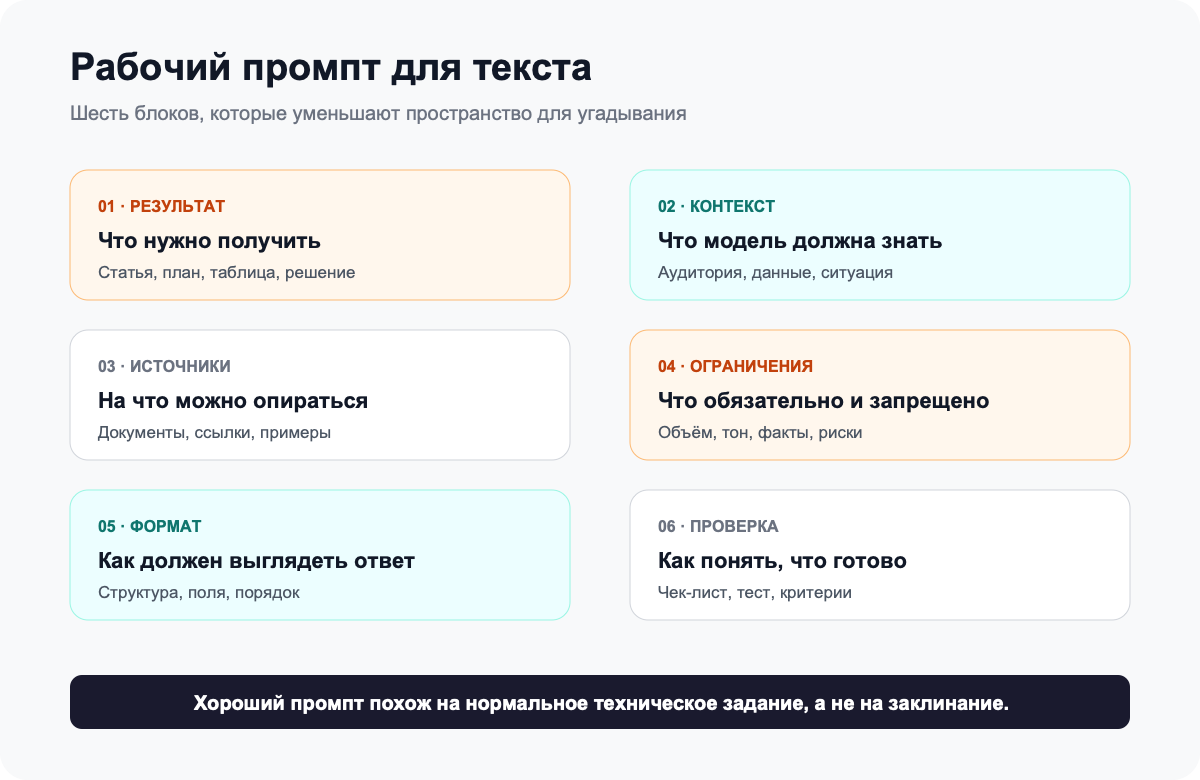
Готовый шаблон выглядит так:
Нужно получить: [результат]. Он нужен для: [цель]. Контекст: [аудитория и ситуация]. Используй: [источники]. Обязательно: [требования]. Не делай: [запреты]. Верни ответ в формате: [структура]. Перед финалом проверь: [3–5 критериев]. Если данных не хватает, перечисли пробелы, а не додумывай.
Обратите внимание на последнюю фразу. Просьба не выдумывать не выключает галлюцинации, но создаёт разрешённый выход из ситуации: модель может сказать «данных недостаточно», вместо того чтобы заполнять пустоты правдоподобным текстом.
Когда примеры сильнее дополнительных инструкций
Если задача связана со стилем, классификацией или строгим форматом, один хороший пример часто полезнее абзаца правил. Такой приём называется few-shot prompting: модели показывают несколько пар «вход → правильный выход», после чего дают новую задачу.
При этом примеры должны быть разнообразными и каноническими. Десять почти одинаковых образцов не объясняют границы задачи, а длинная коллекция исключений засоряет контекст. Anthropic прямо советует держать набор примеров компактным и покрывать им разные типичные случаи.
Правило сообщает модели, что делать. Пример показывает, как выглядит сделанная работа. Когда формат важен, второй сигнал обычно сильнее.
Например, если вы хотите получать краткие карточки товаров, покажите две карточки: одну для простого продукта и одну для продукта с ограничениями. Модель увидит длину, порядок полей и уровень детализации, которые трудно точно описать словами.
Где работают пошаговое рассуждение и самопроверка
Классическая работа о chain-of-thought показала, что примеры промежуточных рассуждений заметно улучшали решение сложных арифметических, символических и логических задач большими моделями. В исходном эксперименте восемь примеров помогли PaLM 540B получить тогдашний лучший результат на GSM8K.
Следующая работа о self-consistency предложила генерировать несколько независимых путей решения и выбирать согласованный ответ. На GSM8K прирост относительно обычного chain-of-thought составил 17,9 процентного пункта, хотя такой подход закономерно тратит больше вычислений.
Из этого не следует, что к каждому запросу нужно приписывать «думай шаг за шагом». Для письма, пересказа или простого поиска это добавляет токены, но не обязательно качество. Для сложного решения лучше попросить модель разбить задачу, проверить допущения, сравнить несколько вариантов и показать краткое обоснование, которое можно проверить человеку.
Для фактов добавляется ещё один слой: сначала найти источники, потом извлечь подтверждения и лишь затем писать ответ. Убедительное рассуждение модели само по себе не является доказательством.
Почему промпты нужно тестировать, а не полировать на глаз
В 2025 году на EMNLP вышел систематический обзор автоматической оптимизации промптов. Сам факт появления отдельного большого направления полезен практически: хороший промпт можно рассматривать как версию программы, которую улучшают по результатам тестов.
Для этого не нужен сложный стенд. Соберите 10–20 типичных запросов, заранее опишите признаки хорошего ответа и сохраните базовую версию промпта. Затем меняйте один блок, прогоняйте набор снова и сравнивайте ошибки. Так вы отличите реальное улучшение от одного случайно удачного ответа.
Когда задача повторяется часто, этот цикл можно автоматизировать. Но начинать всё равно приходится с понятной метрики, иначе оптимизатор найдёт формулировку, которая выигрывает тест и проигрывает живому пользователю.
Как писать промпты для генерации изображений
В визуальных моделях действует тот же принцип: конкретика сильнее декоративной длины. OpenAI пишет, что для большинства изображений хватает одной-трёх ясных фраз, если в них есть назначение, объект, действие, место, стиль и важные ограничения. Формулировка «мягкий естественный свет из окна слева» надёжнее, чем «красивое освещение».
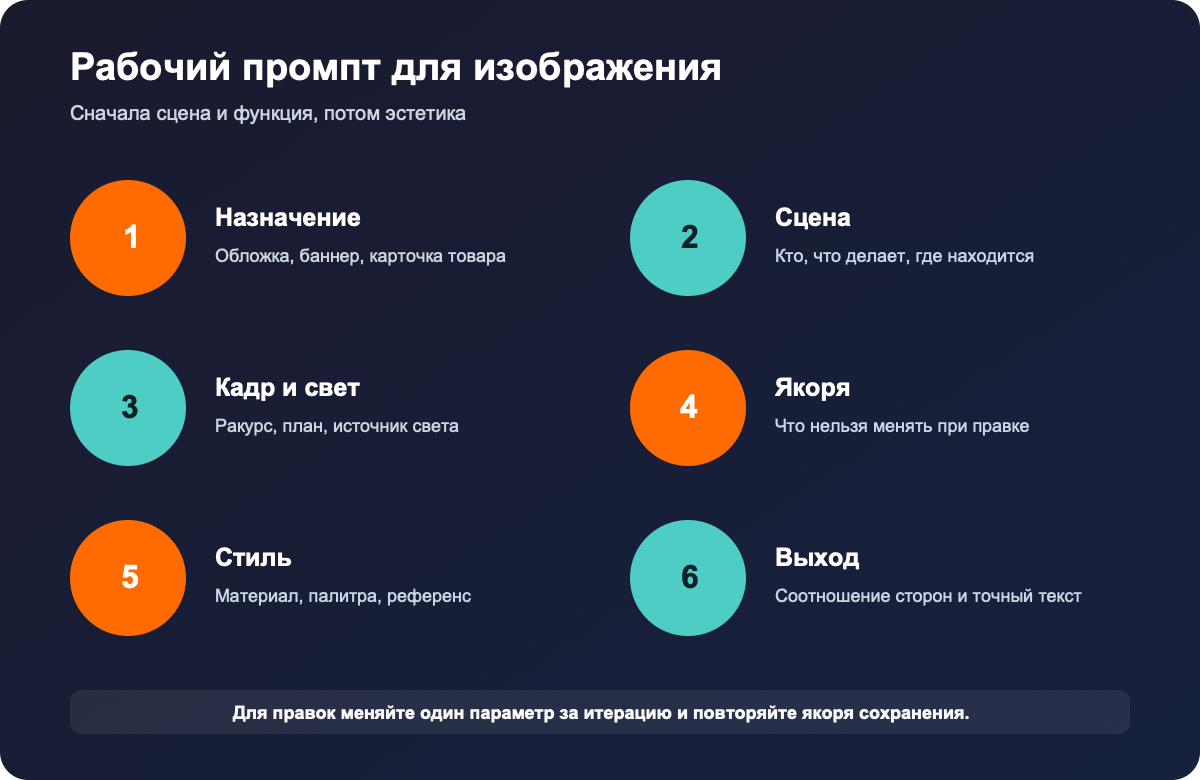
Вот практический шаблон:
Создай [тип изображения] для [назначение]. В кадре [главный объект и действие] в [окружение]. Композиция: [план, ракурс, расположение объектов, свободное место]. Свет: [источник, направление, жёсткость]. Стиль: [материал, палитра, визуальная традиция или референс]. Сохрани без изменений: [лицо, логотип, форму товара, надпись]. Формат: [соотношение сторон, разрешение]. Точный текст в кадре: «[текст]».
Описание камеры работает не как магическое слово, а как язык композиции. «Крупный портрет на уровне глаз» понятнее, чем список моделей объективов, если вы не знаете, какой визуальный эффект даёт каждый из них. То же самое со стилем: лучше назвать материал, палитру и характер изображения, чем складывать двадцать тегов вроде cinematic, epic и masterpiece.
Почему референс стал важнее мешка прилагательных
Современные мультимодальные модели умеют принимать изображения вместе с текстом, поэтому стиль, композицию или идентичность объекта можно показать. OpenAI советует использовать небольшой набор референсов и явно объяснять роль каждого: первое изображение задаёт объект, второе – стиль, третье – композицию.
Если хочется быстро проверить эту механику на готовых заготовках, у меня есть отдельный каталог из 120 команд для картинок в ChatGPT. Там особенно хорошо видно, почему короткая команда задаёт направление, но без объекта, якоря и формата остаётся лотереей.
Google отдельно рекомендует задавать производственный формат, например 1:1, 4:3 или 9:16, а точную надпись передавать в кавычках на нужном языке. Это особенно важно для карточек товара, обложек и рекламы, где красивая картинка с неправильным текстом всё равно бесполезна.
Чем больше референсов вы загружаете без пояснений, тем труднее модели понять, что именно переносить. Поэтому три подписанных изображения обычно полезнее папки из тридцати красивых картинок.
Как редактировать картинку и не потерять исходник
Генерация с нуля и редактирование требуют разных промптов. При редактировании первым делом перечислите якоря сохранения: лицо, позу, ракурс, фон, логотип, цвет упаковки или расположение предметов. Затем опишите одну локальную правку.
Плохой запрос звучит так: «сделай фото профессиональнее». Рабочая версия: «замени только фон на светло-серую студийную стену; сохрани лицо, причёску, одежду, позу, кадрирование и направление света без изменений; не добавляй текст и аксессуары».
Если за один раз попросить поменять фон, одежду, свет, выражение лица и композицию, вы не поймёте, какая инструкция сломала результат. Одна правка за итерацию работает медленнее на бумаге, но быстрее приводит к нужному изображению.
Для генерации описывайте, что создать. Для редактирования сначала фиксируйте, что нельзя менять, и только потом называйте одну правку.
Исследование Dynamic Prompt Optimizing на CVPR 2024 подтверждает более общий вывод: один и тот же способ описания не одинаково хорош для разных генераторов. Авторы обучали оптимизатор, который динамически подбирал промпт под конкретную модель. Для практики это означает простую вещь: храните смысловой бриф отдельно, а синтаксис и параметры адаптируйте к используемому инструменту.
Какие техники я бы перестал использовать
Некоторые советы продолжают кочевать из подборки в подборку, хотя сильные модели уже не требуют такой магии.
Это не значит, что роль бесполезна. Формулировка «ответь как налоговый юрист для владельца ИП» задаёт перспективу, словарь и аудиторию. Просто роль должна не украшать промпт, а добавлять полезное ограничение.
Короткий алгоритм, который работает с любой моделью
Перед отправкой важного запроса я бы прошёл пять шагов.
- Записал результат одним предложением и убрал слова, которые нельзя проверить.
- Добавил контекст, неизвестный модели, и приложил первичные данные.
- Показал один-два примера, если важны стиль или строгий формат.
- Назвал ограничения, формат выхода и признаки готовой работы.
- После ответа проверил факты, сохранил ошибку и изменил только один элемент промпта.
Для изображения шаги почти те же, только пример превращается в референс, а критерии включают композицию, свет, якоря сохранения и формат площадки.
Он обязан уменьшать пространство для угадывания.
В целом промпт-инжиниринг никуда не исчез. Он просто взрослеет: вместо охоты за секретной фразой мы проектируем контекст, примеры, инструменты и контроль качества. Работает. Прикольно.
Для контентных задач эту же логику можно посмотреть на готовых промптах и skills для Instagram, где обычная инструкция развёрнута в повторяемый процесс с входными данными и проверкой.